확률적 앵무새 떼와 ‘쓸모 있는’ AI의 핵심 문제
핵심 요약
AI 에이전트가 유용해지고 있다는 사실을 인정한 채, 그 유용함의 조건을 따져야 한다는 주장입니다.
- 쌓이는 문제: 여러 모델이 코드를 만들고 검증해도 편향, 책임 소재, 자원 소모 문제는 누적돼요.
- 작동과 영향: 코드가 작동한다는 것과 사람에게 좋은 결과를 낸다는 것은 달라요.
- 유용함의 조건: 누가 비용을 치르고 누구에게 이익이 돌아가는지 따져야 해요.

AI 기술은 발전하고 있어요. 대규모 언어 모델이 사회에 미치는 영향을 비판적으로 살펴보는 사람들 앞에도 더 복잡한 과제가 놓였어요. AI 활용에서 에이전트의 비중이 커지고 있거든요.
업계가 말하는 에이전트형 AI는 ‘계획’을 세울 줄 아는 시스템이에요. 다른 코드를 작성하는 코드를 만들고, 여러 앱과 모델을 오가며 여러 단계의 작업을 수행하고, 스스로 적응하는 시스템이죠. 업계는 에이전트가 무언가를 아는 능력보다 만드는 능력을 앞세워요. 프롬프트에 답해 글이나 이미지를 만드는 데 그치지 않고, 현실에서 일을 처리하도록 설계한 맞춤형 소프트웨어를 만들어 내요. 여러 결과를 만들어 평균을 내거나 다른 에이전트에게 검증을 맡기는 방식으로, 이전 모델을 괴롭히던 신뢰성 문제도 일부 나아지고 있어요. 코드의 오류는 눈에 띄고 고칠 수 있다고 여겨지기도 하고요.
이런 발전으로 LLM을 쓰는 경험이 실제로 좋아지고 있어요. 그렇다고 AI 산업이 옳았다는 게 증명된 걸까요? 새 모델이 세상을 바꿀 테니 그 영향을 이해하는 틀도 바꿔야 한다는 평론과 논평이 이미 넘쳐나요. 특히 AI 업계의 두 거물인 OpenAI와 Anthropic이 조만간 기업공개를 준비한다는 이야기도 나와요. 두 회사가 시장에서 더 높은 평가를 받으려 경쟁하는 만큼 과장된 홍보도 심해질 거예요. 동시에 그들이 파는 모델도 실제로 발전하겠죠.
두 이야기는 동시에 참일 수 있어요. 이 회사들의 제품은 더 빨리 반응하고 더 많은 일을 해내는 듯해요. 복잡한 과제도 능숙하게 처리하죠. 문제를 해결할 코드를 만들고, 제대로 작동할 때까지 계속 고쳐 쓰기도 해요. 많은 사용자가 분명히 느끼는 변화를 부정할 때가 아니에요. 기술이 ‘쓸모 있다’는 데 사람들이 동의하더라도, 비판적 연구가 제기해 온 근본적인 문제는 남아 있어요.
• • •
비판의 출발점
Emily M. Bender, Timnit Gebru, Angelina McMillan-Major, Margaret Mitchell은 2021년의 중요한 논문에서 LLM을 확률적 앵무새라고 불렀어요. 학습 데이터에서 통계적으로 그럴듯한 패턴을 재현하는 시스템이라는 뜻이죠. 이 관점은 여전히 유효해요. 다만 시스템이 더 복잡하고 속을 알기 어려워지면서, 텍스트에 사고와 의도가 있다고 믿기 쉬웠던 것처럼 이제는 코드에도 그런 의미를 부여하기 쉬워졌어요.
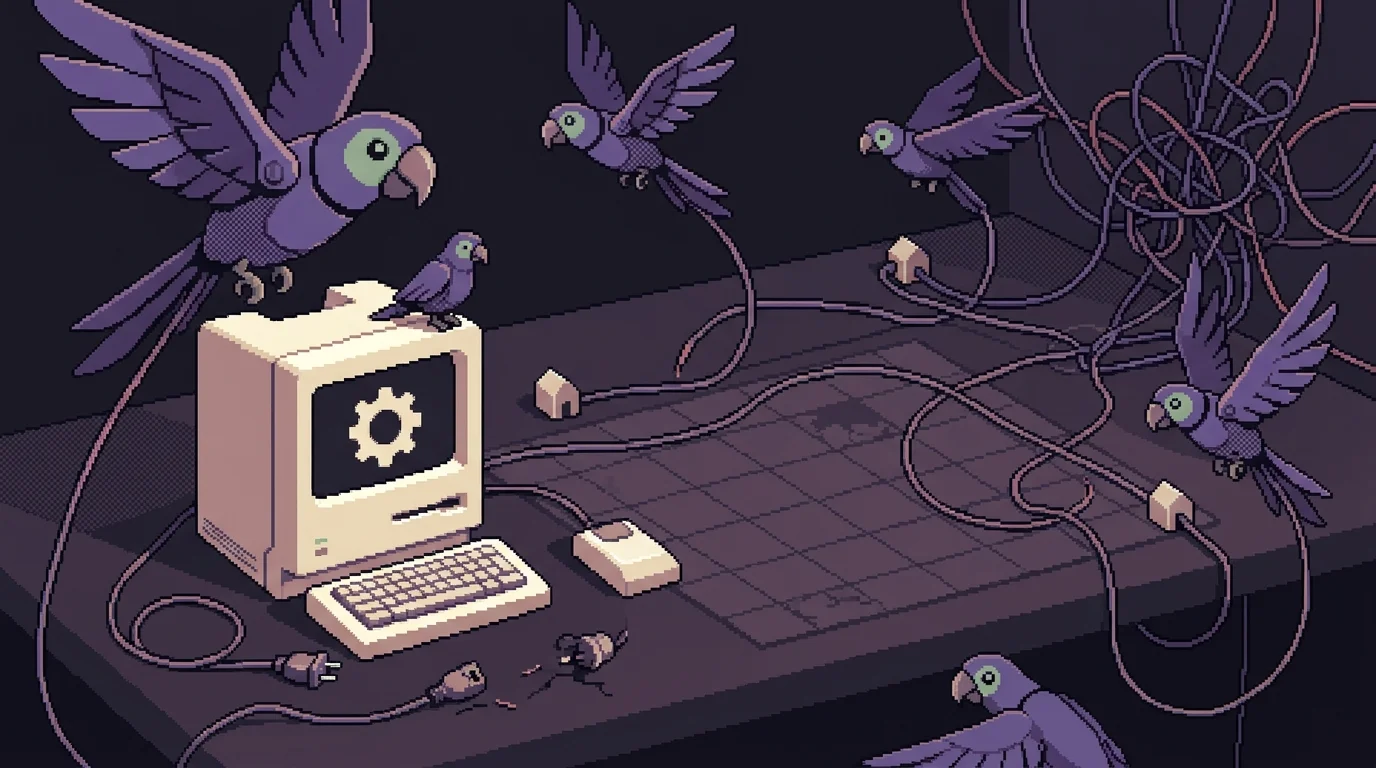
에이전트형 시스템에서는 여러 앵무새의 출력이 서로 영향을 주고받아요. 확률적 앵무새 떼인 셈이죠. 주식 시장의 초고속 매매 알고리즘과 비슷하지만, 여기서는 주식 대신 언어와 코드를 만들어 내요. (흥미롭게도 앵무새 무리를 가리키는 영어 표현은 pandemonium, 곧 ‘대혼란’이에요.)
사용 경험과 활용 방식은 달라질 수 있어요. 하지만 책임을 묻기 어렵다는 근본적인 문제와 AI 산업을 떠받치는 이념적·물질적 기반은 그대로예요. 대규모 데이터 수집과 처리에 거액이 투입되는 지금도, 그 논문의 핵심 질문인 ‘언어 모델은 지나치게 커질 수 있는가?’는 5년 전만큼 중요해요. 알고리즘 편향을 밝혀내고, 모델 학습에 드는 환경 비용을 추적하고, 데이터 생산에 얽힌 노동 관행에 문제를 제기한 연구자들이 있죠. 학계에서 AI를 무비판적으로 받아들이려는 움직임에 저항해 온 사람들도 있어요. 이들은 그저 반대하기 위해 반대하는 게 아니에요. AI를 도입하려면 최소한 어떤 인간적 조건을 갖춰야 하는지 말해 왔죠. 앵무새가 떼를 이루면 편향과 비효율은 더 커지고, 사람들은 AI에 생각하는 마음이 있다고 더 쉽게 착각할 수 있어요.
시스템 자체를 비판하는 일과 모델의 성능을 평가하는 일은 달라요. 둘을 구분한다고 해서 과장된 홍보를 받아들이는 건 아니에요. 개인이 어떻게 쓰는지만 볼 게 아니라, 사회 전체가 얻는 이익과 입는 피해를 살펴보자는 뜻이죠. 모델이 할 수 있는 일을 인정하면서도, 무엇을 할 수 없고 무엇을 해서는 안 되는지 이야기할 수 있어요.
• • •
에이전트형 AI가 가져오는 문제
슬롭웨어의 물결
에이전트가 퍼지면서 슬롭웨어(slopware)T1도 늘어요. 사람이 제대로 검토하기도 전에 쏟아져 나오는 AI 생성 소프트웨어예요. 흔히 당장 눈앞의 문제만 풀도록 만들어지고, 사용자 한 사람의 필요를 무엇보다 우선하죠. 이런 코드를 다른 사람에게 배포하거나 다른 시스템과 연결하면 어떻게 될까요? 통제하는 사람 없이 수많은 비행체가 제각각 날아다니는 하늘처럼, 대혼란이 생기죠.
갖가지 임시방편이 근본적인 실수를 가리면, 제한된 조건에서는 코드가 잘 작동하는 듯 보여요. 슬롭웨어는 악성코드와 달리 일부러 해를 끼치지는 않아요. 부주의해서 해를 끼치죠. 독신 남성이 쓰는 가계부 프로그램은 코드에 고정해 둔 값 덕분에 잘 돌아가지만, 한부모 여성이 쓰면 계좌 잔액이 부족해 수수료를 물게 되는 식이에요. 소프트웨어를 설계할 때는 어떤 가치와 우선순위를 담을지 신중히 정해야 해요. 처리하는 데이터를 어떻게 왜곡하거나 버리거나 잘못 보여 줄 수 있는지도 살펴야 하죠. 이를 따져 보려면 기술 지식은 물론, 코드가 해결하려는 문제에 도움이 되는지 오히려 해가 되는지 판단하는 눈도 필요하고요.
기술적 실패의 누적
전보다 믿을 만해 보여도 LLM이 진실을 가려내는 기계가 될 수는 없어요. 이른바 환각을 수학적으로 완전히 없앨 수 없기 때문이죠. 그런데 더 믿을 만해졌다는 인상 때문에 특정 작업에 LLM이 적합한지 과대평가하기 쉬워요. 언어 모델이 그럴듯하지만 틀릴 수 있는 글이나 이미지를 만든다면, 에이전트형 시스템은 그럴듯한 코드를 만들어요. 에이전트가 코드를 만드는 과정은 모델 하나가 답변을 내놓을 때보다 중간에 멈추거나 추적·감사하기 어려워요. 코드가 만들어진 과정을 믿을 만하게 설명할 수도 없으니, 검증하기 전까지는 믿지 말아야 해요.
책임 실패의 누적
에이전트형 시스템의 오류는 겉으로 문제가 드러날 때까지 보이지 않게 쌓여요. 사람의 삶과 맞닿은 시스템에서는 작은 오작동도 누군가를 해칠 수 있죠. 정부에도 복지 수급 결정, 계약 분석, 규제 검토 등을 이런 시스템으로 자동화하라는 권유가 이어지고 있어요. 연쇄 오류가 심각한 피해로 번질 수 있는 분야들이죠. 어느 시골 마을이 쓰레기 수거 일정을 짜는 코드를 만들었는데, 알고 보니 그 코드가 매일 밤 삭제되는 엑셀 파일에 요청을 보내고 있을 수도 있어요. 정부는 복지 급여를 부당하게 거부당한 은퇴자에게 일을 떠넘겨 시간을 아끼기 위해 존재하는 게 아니잖아요.
컴퓨터로만 해결하려는 사고
모든 문제가 코딩으로 풀리지는 않아요. 코드를 쉽게 만들 수 있게 되면 정책 과제마저 새 코드 몇 줄로 해결하려 하고, 기계가 이해할 수 있는 문제에만 눈을 돌리게 돼요. 정책 담당자와 기업, 학계, 언론이 모두 이렇게 생각하기 시작하면, 사람을 문제에서 지워 버리는 데도 익숙해져요. 컴퓨터 시스템에 맞춰 사고하다 보면 경계가 흐린 사례를 사회의 자연스러운 일부가 아니라 기술적으로 성가신 예외로 보게 되죠. 공동체의 문제를 대신 해결해 주는 시뮬레이션은 없어요. 현실의 복잡함을 함께 다루는 과정은 세상을 이해하고 민주주의를 꾸려 가는 데 꼭 필요해요.
자원 추출과 낭비의 확대
에이전트형 시스템은 작업을 반복하기 때문에 목적에 맞게 만든 소프트웨어보다 훨씬 많은 자원을 써요. 초보자가 에이전트로 코드 한 줄을 고칠 때도 모델 하나만 쓰는 게 아니에요. 앵무새 떼 전체를 작동시키죠. 이 거대한 시스템은 한 사람이 결과물을 더 많이, 더 빨리 내도록 설계됐어요. 코드가 얼마나 효율적인지, 어떤 영향을 미치는지는 뒷전이에요. 환경에만 피해를 주는 게 아니에요. 모두가 공유하는 정보 환경을 해치고, 그 코드를 나중에 믿고 쓰는 사람들에게 문제를 남기죠. 에이전트 떼는 개인에게 더 많은 계산 능력을 주면서, 그 뒤에 깔린 방대한 노동과 자원 채굴은 프롬프트 창 하나에 가려 버려요.
• • •
오래 남는 질문
지금까지 살펴본 문제는 에이전트형 시스템이 실제로 유용하다고 가정해도 생겨요. 이 밖에도 LLM을 비판할 근거는 많아요. AI 산업이 행사하는 정치적 권력, 과장에 기대어 성급하게 도입하는 관행, 감시의 위험을 따질 수 있죠. 비인간적인 데이터 추출이라는 원죄와 여성혐오, 인종차별 같은 편향도 있어요. 여기에 ‘그런데 작동도 안 하잖아!’라고 덧붙이고 싶을지도 몰라요. 온라인에서 비판자들은 언어 모델의 실수를 밈으로 퍼뜨리며 함께 웃고 연대감을 느끼죠. 하지만 그 장면을 사람들이 일상에서 실제로 겪는 사용 경험과 혼동해서는 안 돼요.
AI의 실수를 조롱하는 데 그치면 우리가 꼭 다뤄야 할 문제를 비켜 가요. 작동하지 않는 시스템이라면 노동을 위협하지 않을 거예요. 아무도 쓰지 않는 시스템이라면 환경을 위협하지 않겠죠. 무너지는 업계가 억지로 떠받치는 시스템이라면 결국 사라질 테니 기다리기만 하면 될 거예요. 하지만 이건 원칙과 근거를 갖춘 비판이라기보다 수동적인 태도예요. 실제로 유용하다고 느끼는 사람이 늘어나는 현실에도 맞지 않고요. 에이전트형 AI가 기술의 새 방향을 정한다면, 설계상의 결정은 제쳐 두고 모델의 ‘지능’만 살피는 AI 안전 논의로는 부족해요.
지금 시급히 따져야 할 것은 유용함의 경계예요. 유용하다는 건 무슨 뜻일까요? 누구에게, 어떤 조건에서 유용할까요? 누가 어떤 대가를 치르고, 그 덕에 누가 이익을 얻나요? 이익과 위험은 어떻게 나뉘나요? 어떤 결정들이 공론장에서 조용히 빠져 기업과 정부 등의 자동화 시스템에 맡겨지고 있을까요?
사람들이 언어 모델을 쓴다고 해서 비판이 무의미해지는 건 아니에요. 오히려 더 시급해져요.
역자 주
- 슬롭웨어(slopware): 저자가 ‘슬롭(slop)’과 ‘소프트웨어(software)’를 합쳐 쓴 말이에요. ‘슬롭’에는 AI가 대량으로 만들어 낸 조악한 콘텐츠를 낮춰 부르는 뜻이 담겨 있어요. ↩
원문: Stochastic Flocks and the Critical Problem of ‘Useful’ AI, Eryk Salvaggio, Tech Policy Press, 2026년 2월 22일.
번역 초안: OpenAI Codex